Comment construire un assistant RAG sur les documents de votre entreprise
La génération augmentée par récupération permet à un LLM de répondre à partir de vos documents au lieu d'inventer. Voici l'architecture que j'ai utilisée dans une vraie plateforme data, étape par étape.
Qu'est-ce qu'un assistant RAG ?
Un assistant RAG (retrieval-augmented generation, génération augmentée par récupération) est un chatbot qui répond aux questions à partir de vos documents. Avant d'appeler le modèle de langage, il cherche dans une base de connaissances les passages les plus pertinents et les donne au modèle comme contexte. Le modèle doit répondre uniquement à partir de ce contexte et le citer.
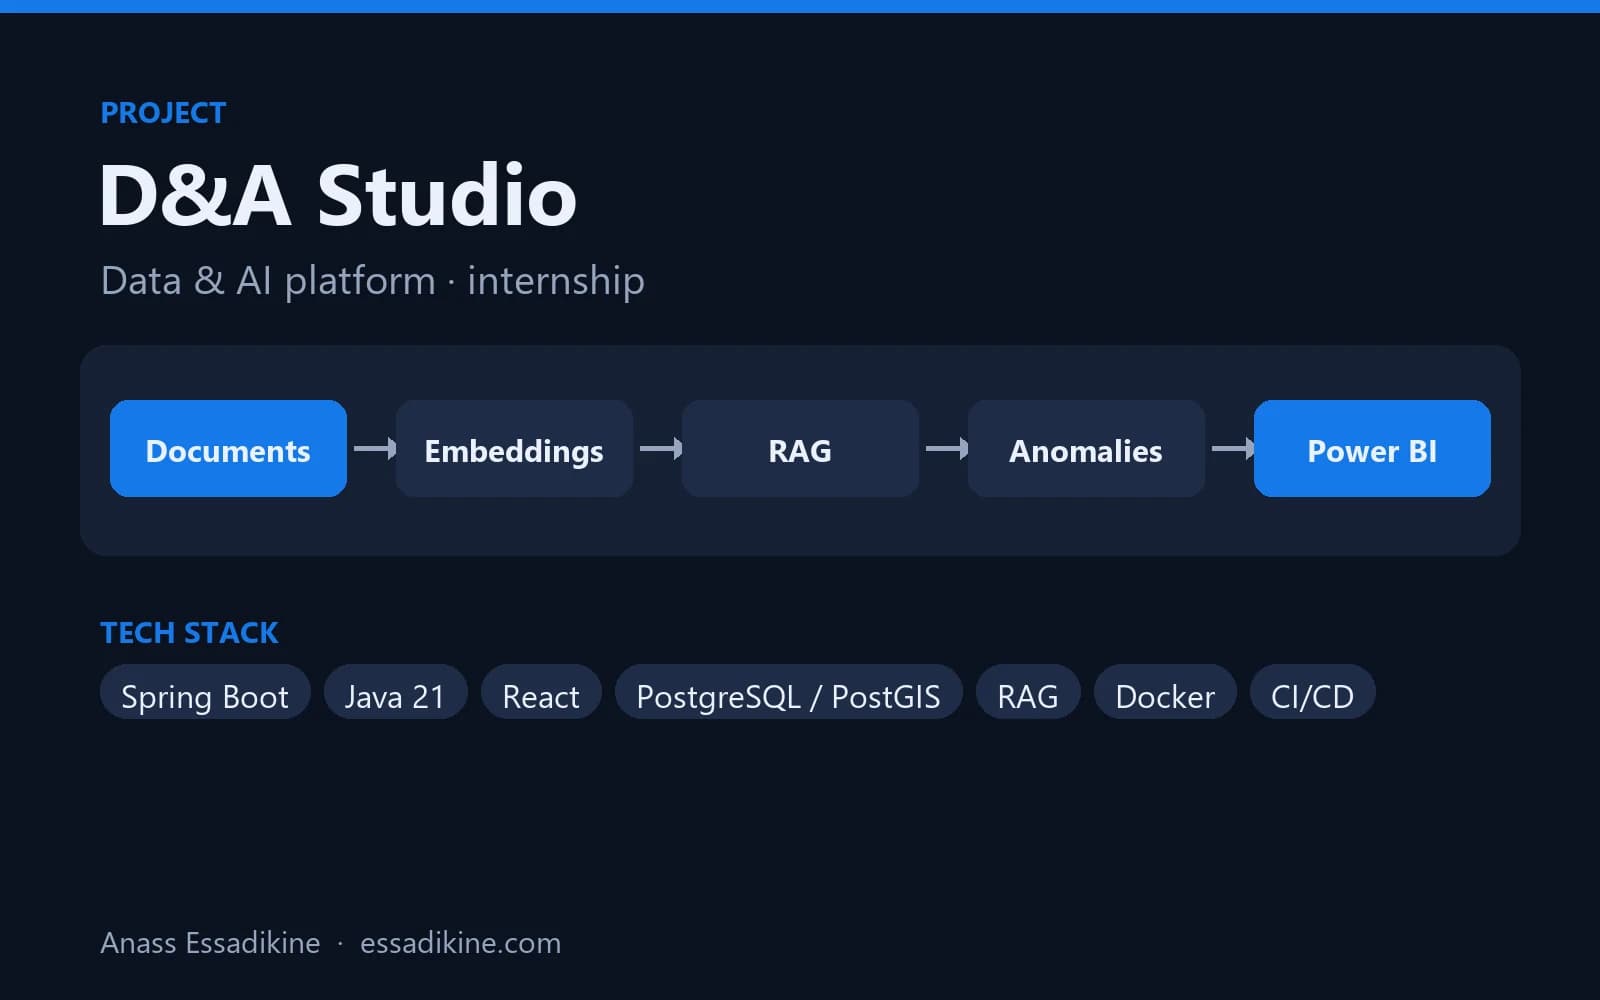
Cela résout les deux problèmes d'un LLM utilisé seul en entreprise : il ne connaît pas vos documents internes, et il invente quand il ne sait pas. J'ai construit ce type d'assistant dans D&A Studio, la plateforme data développée pendant mon stage de fin d'études (voir le projet).
Comment fonctionne un pipeline RAG ?
Il y a deux phases.
1. Indexation (une fois, puis à chaque modification de document)
- Charger les documents (PDF, Word, pages web, exports de base de données).
- Nettoyer le texte et le découper en passages de quelques centaines de tokens.
- Calculer un embedding (un vecteur qui représente le sens) pour chaque passage.
- Stocker le texte, les métadonnées et le vecteur dans un index vectoriel.
2. Réponse (à chaque question)
- Calculer l'embedding de la question.
- Retrouver les k passages les plus similaires (similarité cosinus).
- Construire un prompt avec les consignes, les passages et la question.
- Appeler le LLM et renvoyer la réponse avec ses sources.
Quels outils utiliser ?
Pas besoin d'une nouvelle base de données. Si vous utilisez déjà PostgreSQL, l'extension pgvector ajoute un type vector et la recherche par similarité :
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE doc_chunks (
  id        BIGSERIAL PRIMARY KEY,
  doc_id    TEXT NOT NULL,
  title     TEXT,
  content   TEXT NOT NULL,
  embedding VECTOR(768)
);

CREATE INDEX ON doc_chunks USING hnsw (embedding vector_cosine_ops);
La recherche devient une seule requête (<=> est l'opérateur de distance cosinus) :
SELECT doc_id, title, content
FROM doc_chunks
ORDER BY embedding <=> $1   -- embedding de la question
LIMIT 5;
Côté application, n'importe quelle stack convient. Dans D&A Studio l'API est en Spring Boot ; pour les prototypes j'utilise Python. Une fonction de réponse minimale ressemble à ceci :
def answer(question: str) -> dict:
    q_vec = embed(question)                       # même modèle qu'à l'indexation
    chunks = search_similar(q_vec, k=5)           # requête pgvector ci-dessus
    context = "\n\n".join(f"[{i+1}] {c.content}" for i, c in enumerate(chunks))
    prompt = (
        "Réponds UNIQUEMENT à partir du contexte. "
        "Si la réponse n'y est pas, dis que tu ne sais pas. "
        "Cite les sources sous la forme [1], [2]...\n\n"
        f"Contexte :\n{context}\n\nQuestion : {question}"
    )
    return {"answer": llm(prompt), "sources": [c.doc_id for c in chunks]}
Comment bien découper les documents ?
Le découpage a plus d'impact sur la qualité que le choix du modèle.
- Taille : 300 à 500 tokens par passage avec environ 50 tokens de chevauchement.
- Respecter la structure : couper sur les titres et paragraphes, pas au milieu d'un tableau.
- Garder les métadonnées : titre du document, section, date et URL accompagnent chaque passage ; ils aident le classement et permettent d'afficher les sources.
- Nettoyer d'abord : supprimer en-têtes, pieds de page et numéros de page répétés.
Comment empêcher l'assistant d'inventer ?
- Demander explicitement au modèle de répondre uniquement à partir du contexte, sinon de dire « je ne sais pas ».
- Renvoyer les sources avec chaque réponse pour que l'utilisateur puisse vérifier.
- Fixer un seuil de similarité : si aucun passage n'est assez proche, ne pas appeler le LLM.
- Garder une température basse (0 à 0,3) pour des réponses factuelles.
- Restreindre l'accès : l'assistant ne doit chercher que dans les documents que l'utilisateur a le droit de voir (accès par rôle).
Comment évaluer un assistant RAG ?
Rédigez 20 à 50 vraies questions avec la réponse attendue et le document qui la contient, puis mesurez :
- Taux de récupération : le bon passage est-il dans le top 5 ?
- Fidélité : chaque affirmation est-elle appuyée par les passages récupérés ?
- Refus : l'assistant dit-il « je ne sais pas » pour les questions hors documents ?
Relancez ce jeu de tests à chaque changement de taille de passage, de modèle d'embedding ou de prompt.
Conseils pratiques
Sur les longs documents techniques, découpez par titres de section plutôt qu'en longueurs fixes et ajoutez le titre de section au début de chaque passage : la recherche devient nettement plus précise. Et affichez toujours les sources : les utilisateurs vérifient les réponses et font davantage confiance à l'assistant.
Besoin d'un assistant RAG pour votre entreprise ?
Je construis des assistants RAG et des automatisations IA pour des entreprises au Maroc et à distance. Voir mes services ou me contacter.
Projets liés
 IA & AutomatisationStage · 2026
D&A Studio — Plateforme Data & IA (PaaS)
Une plateforme qui réunit données de traçage géospatial, assistant IA sur les documents de l'entreprise, détection d'anomalies et tableaux de bord BI.
 Génie logicielProjet académique · 2024
Application de gestion de blog (MERN + assistant IA)
Une plateforme de blog MERN complète avec authentification, gestion de contenu et assistant IA.
Questions fréquentes
Le RAG récupère au moment de la question les passages pertinents de vos documents et les donne au modèle. Le fine-tuning modifie les poids du modèle. Pour répondre à partir de documents d'entreprise qui changent souvent, le RAG est moins cher, plus rapide à mettre à jour et peut citer ses sources.