Qualité des données et détection d'anomalies en pratique
Des chiffres faux dans un tableau de bord détruisent la confiance plus vite que des rapports lents. Voici mon approche en couches : règles d'abord, statistiques ensuite, machine learning seulement si nécessaire.
Pourquoi la qualité des données est un problème d'ingénierie
Un tableau de bord qui affiche une seule fois un total faux perd la confiance de ses utilisateurs pour des mois. La plupart des erreurs sont banales : un import en double, une colonne qui change de format, un jour de données manquant, un capteur bloqué. La détection d'anomalies sert à repérer ces problèmes avant que les utilisateurs les voient — c'est l'un des modules que j'ai développés dans D&A Studio.
Couche 1 — Contrôles par règles (simples et indispensables)
À exécuter à chaque chargement, en SQL ou dans le pipeline :
| Contrôle | Exemple de règle |
|---|---|
| Complétude | customer_id n'est jamais nul |
| Unicité | pas de invoice_id en double |
| Validité | amount >= 0, pas de dates futures |
| Intégrité référentielle | chaque region_id existe dans la table des régions |
| Fraîcheur | les données de la veille sont arrivées à 8 h |
| Volume | nombre de lignes à ±30 % de la moyenne sur 7 jours |
Un contrôle d'unicité tient en une requête :
SELECT invoice_id, COUNT(*) AS n
FROM staging_invoices
GROUP BY invoice_id
HAVING COUNT(*) > 1;
Si elle renvoie des lignes, arrêtez le chargement ou placez ces lignes dans une table de quarantaine.
Couche 2 — Détection statistique d'anomalies
Les règles repèrent les valeurs impossibles ; les statistiques repèrent les valeurs inhabituelles. Un z-score robuste sur une fenêtre glissante fonctionne bien pour des indicateurs quotidiens :
import pandas as pd

def flag_anomalies(df: pd.DataFrame, col: str, window: int = 28, threshold: float = 3.5):
    roll = df[col].rolling(window, min_periods=7)
    median = roll.median()
    mad = roll.apply(lambda x: (abs(x - x.median())).median(), raw=False)
    robust_z = 0.6745 * (df[col] - median) / mad.replace(0, float("nan"))
    df["anomaly"] = robust_z.abs() > threshold
    return df
La médiane et la MAD (écart absolu médian) sont moins sensibles aux valeurs aberrantes que la moyenne et l'écart-type.
Couche 3 — Machine learning, pour les cas complexes
Quand une anomalie dépend de plusieurs variables à la fois (heure, lieu, montant), un modèle non supervisé comme Isolation Forest est un bon point de départ :
from sklearn.ensemble import IsolationForest

features = df[["amount", "hour", "items", "distance_km"]]
model = IsolationForest(contamination=0.01, random_state=42).fit(features)
df["is_anomaly"] = model.predict(features) == -1
Commencez par les règles et les statistiques. N'ajoutez un modèle que s'ils ratent de vrais problèmes, et montrez toujours pourquoi une ligne est signalée.
Que faire quand un contrôle échoue ?
La détection ne sert à rien sans action :
- Bloquer ou mettre en quarantaine — les contrôles critiques arrêtent le pipeline.
- Signaler — les anomalies non critiques sont chargées mais marquées, et les tableaux de bord peuvent afficher un avertissement.
- Alerter un responsable — envoyer le contrôle en échec, quelques lignes et un lien à la personne qui peut corriger la source (e-mail, Teams, Telegram).
- Suivre — garder l'historique des contrôles pour voir si la qualité s'améliore.
Conseil pratique
En pratique, beaucoup d'anomalies ne sont ni des fraudes ni des pannes de capteurs, mais des problèmes de pipeline comme des imports en double ou des fichiers en retard. Les contrôles de fraîcheur et de volume — les plus simples — sont les premiers à mettre en place.
Besoin de pipelines de données fiables ?
Je construis des pipelines de données, des contrôles qualité et des tableaux de bord. Voir mes services ou me contacter.
Projets liés
 IA & AutomatisationStage · 2026
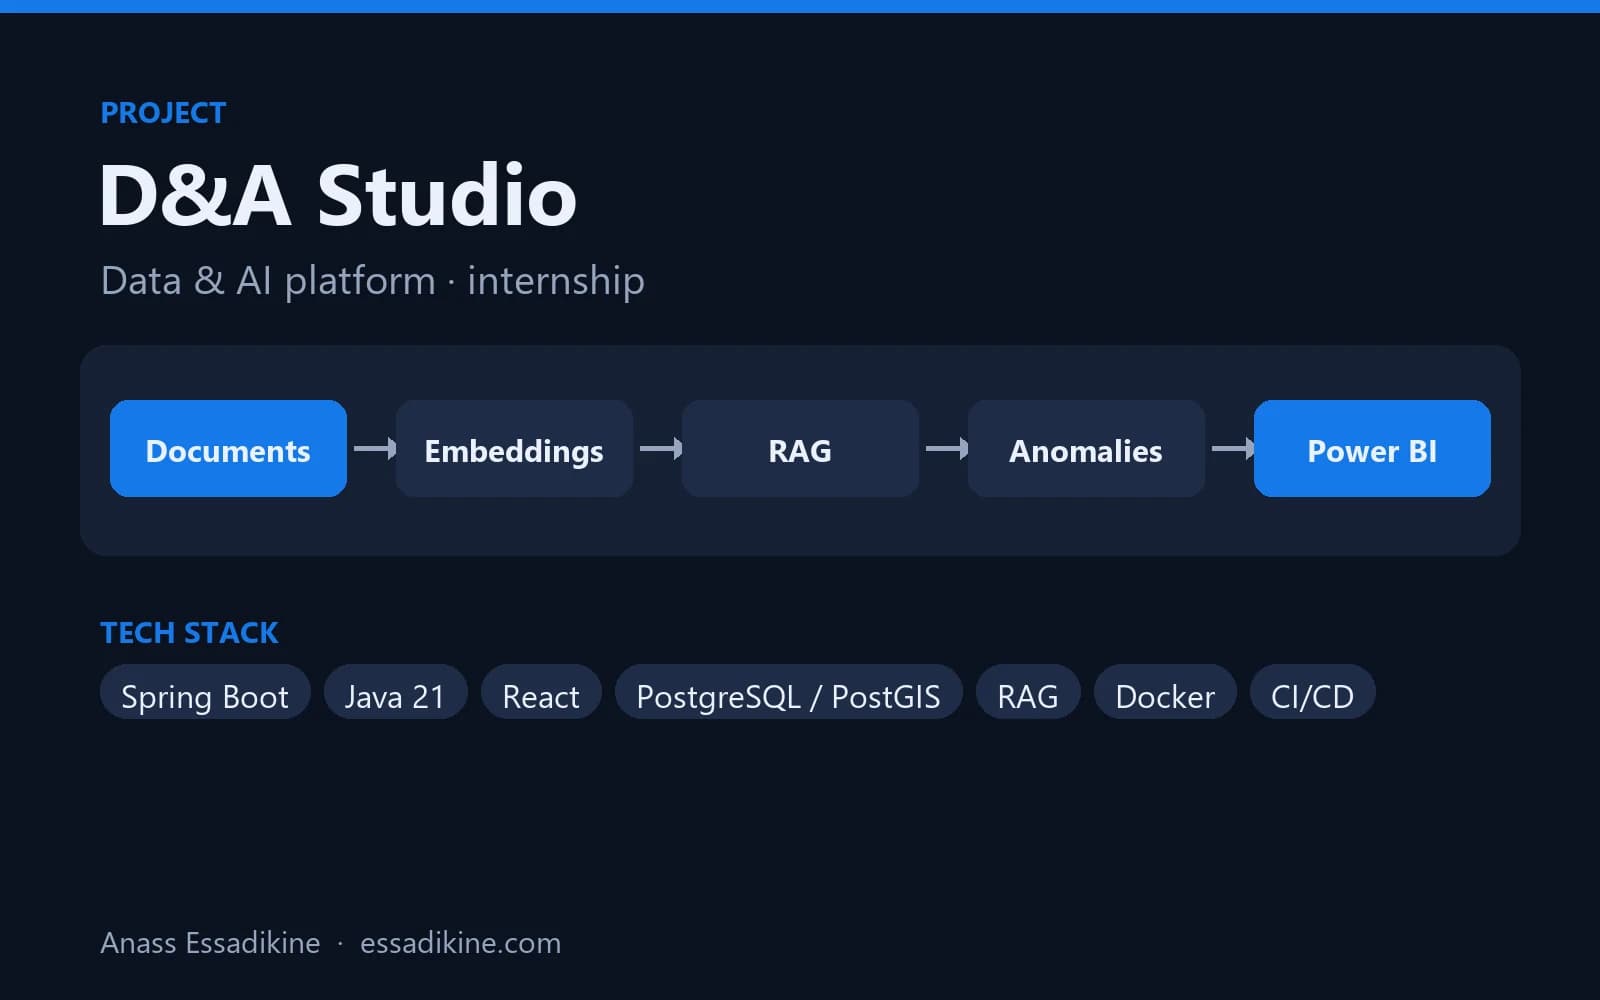
D&A Studio — Plateforme Data & IA (PaaS)
Une plateforme qui réunit données de traçage géospatial, assistant IA sur les documents de l'entreprise, détection d'anomalies et tableaux de bord BI.
 Analyse de données & BIProjet académique · 2025
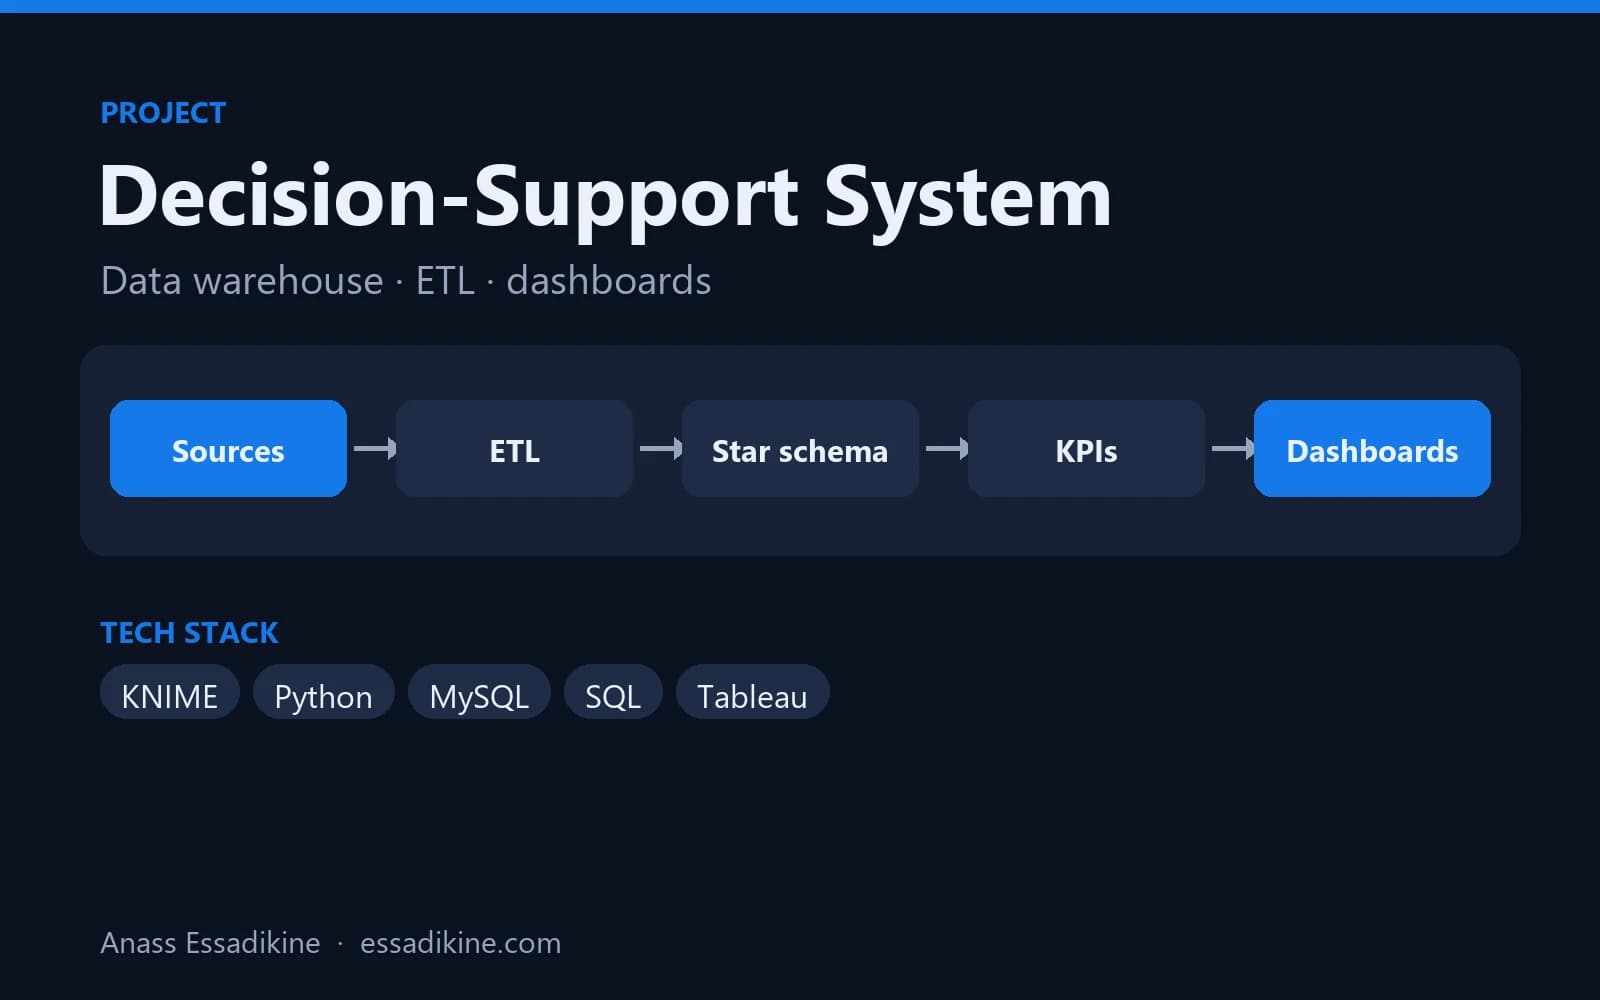
Système décisionnel pour les données de sécurité sociale (CNSS)
Un entrepôt de données en schéma en étoile alimenté par des flux ETL, avec des tableaux de bord analytiques pour les décideurs.
Questions fréquentes
La validation vérifie des règles fixes (non nul, unique, dans une plage). La détection d'anomalies cherche des valeurs possibles mais inhabituelles par rapport à l'historique. Il faut les deux.