Aller au contenu
Services

Ingénierie des données & pipelines ETL

Pipelines ETL/ELT, entrepôts de données et contrôles qualité en Python et SQL, pour des rapports toujours basés sur des données propres et à jour.

En bref

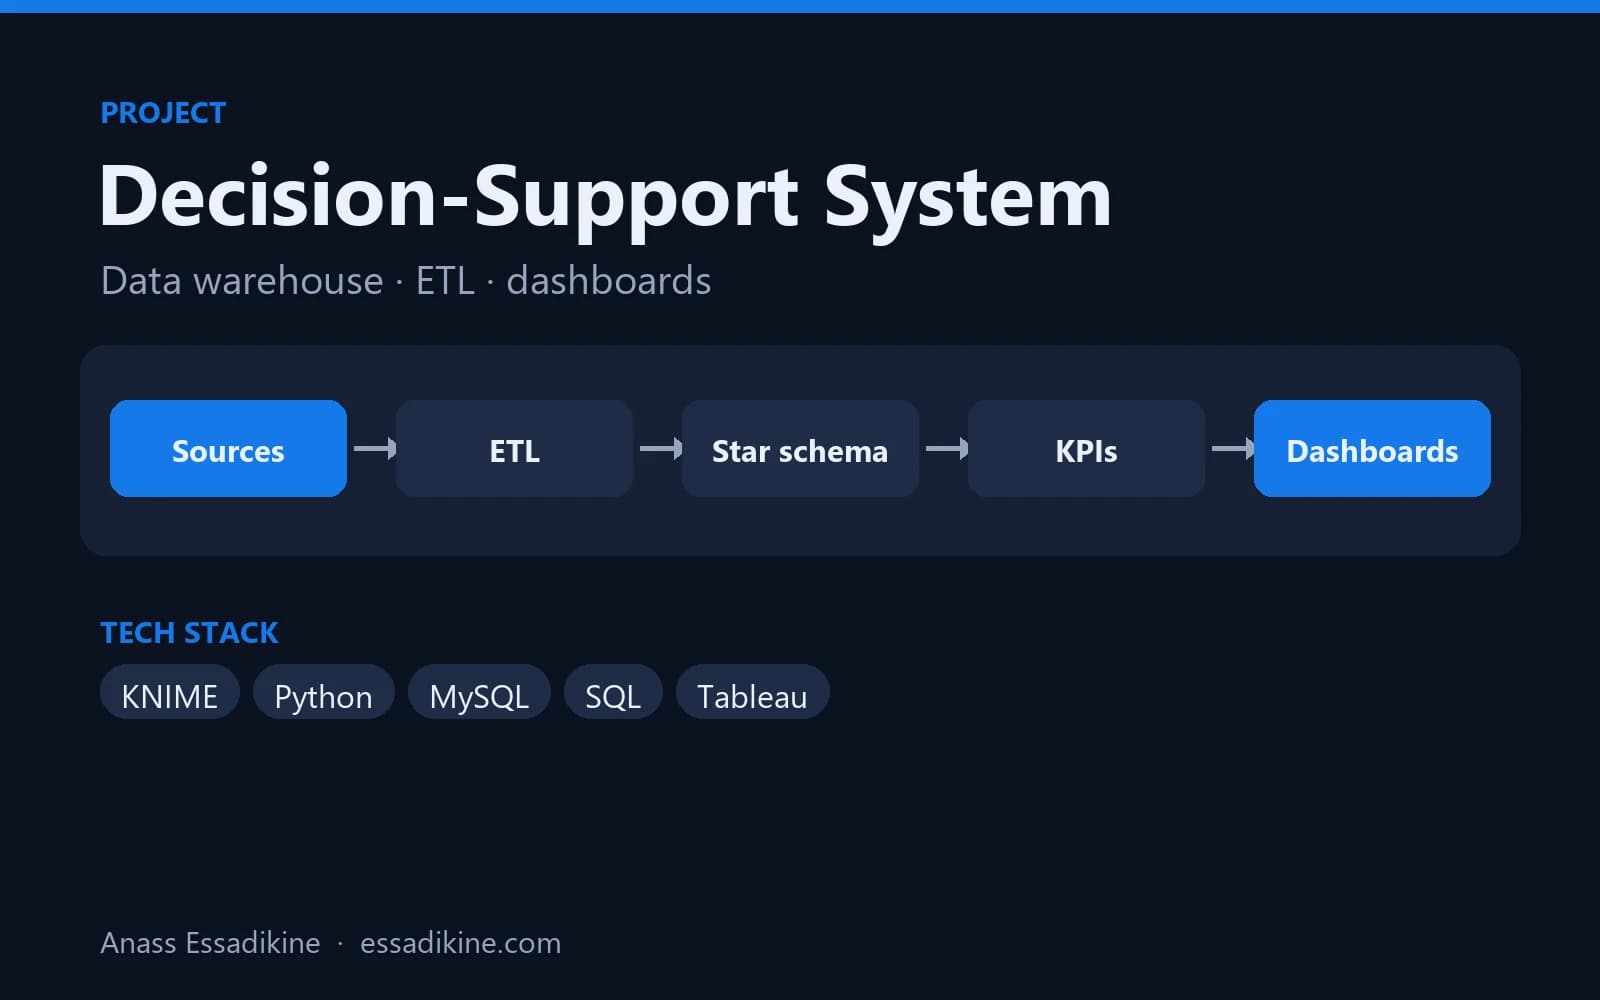
Je conçois et développe des pipelines de données qui collectent vos fichiers, API et bases, nettoient et modélisent les données, puis les chargent dans un entrepôt prêt pour le reporting. Les pipelines sont écrits en Python et SQL, planifiés, surveillés et incluent des contrôles qualité pour repérer les problèmes avant vos tableaux de bord.

Ça vous parle ?

  • La préparation des données est manuelle, lente et source d'erreurs
  • Les rapports cassent dès qu'un fichier source change
  • Pas d'endroit unique et fiable pour les données d'analyse

Ce que vous obtenez

  • Extraction depuis fichiers, API et bases de données
  • Nettoyage, transformation et modèle de données (entrepôt)
  • Planification et supervision, avec contrôles qualité et alertes
  • Documentation des sources, transformations et tables

Comment nous travaillons

1. Audit

Sources, volumes, fréquence et problèmes actuels.

2. Conception

Modèle cible, étapes du pipeline et contrôles.

3. Développement

Pipelines Python/SQL, tests et planification.

4. Exploitation

Supervision, alertes et transmission.

Tarifs

À partir de 2 500 MAD pour un premier pipeline automatisé

Réalisations liées

Articles liés

Questions fréquentes

Principalement Python (pandas, PySpark si les volumes l'exigent), SQL, Airflow ou des planificateurs simples, et PostgreSQL, MySQL ou SQL Server comme entrepôt. Je choisis la stack la plus légère adaptée à vos volumes.

Construisons ensemble quelque chose de grand

Que vous ayez besoin d'une application web full-stack, d'un tableau de bord data ou d'un déploiement cloud-native — j'aimerais en discuter.