ETL vs ELT : différences, exemples en Python et SQL, et comment choisir
L'ETL transforme les données avant de les charger ; l'ELT charge d'abord les données brutes puis les transforme dans l'entrepôt. Voici ce qui change concrètement, avec du code exécutable.
L'ETL et l'ELT font les mêmes trois opérations — extraire, transformer, charger — dans un ordre différent. L'ETL transforme les données avant de les charger dans la base cible ; l'ELT charge d'abord les données brutes puis les transforme dans l'entrepôt, généralement en SQL. Le bon choix dépend de vos volumes, de votre base cible et des compétences de l'équipe qui maintiendra le pipeline.
Qu'est-ce que l'ETL ?
ETL signifie Extract, Transform, Load (extraire, transformer, charger) :
- Extraire — lire les données dans leurs sources : exports CSV ou Excel, ERP, CRM, API, base de production.
- Transformer — les nettoyer et les restructurer en dehors de la cible : corriger les types, supprimer les doublons, normaliser les libellés, calculer les montants, croiser les sources.
- Charger — écrire le résultat propre dans la cible (entrepôt de données, base de reporting, datamart).
La transformation tourne dans un moteur dédié : un script Python avec pandas, un outil visuel comme KNIME, Talend ou SSIS. L'entrepôt ne reçoit que des données déjà propres.
Qu'est-ce que l'ELT ?
ELT signifie Extract, Load, Transform. Les données brutes sont copiées telles quelles dans une zone de staging de l'entrepôt, puis transformées à l'intérieur de celui-ci en SQL. Les entrepôts cloud (BigQuery, Snowflake, Azure Synapse, Redshift) et PostgreSQL sont assez puissants pour exécuter eux-mêmes ces transformations, et des outils comme dbt organisent le SQL en modèles versionnés et testés.
Le grand avantage : les données brutes restent disponibles. Si une règle métier change, on relance le SQL au lieu de tout réextraire.
Quelle est la différence entre ETL et ELT ?
| Critère | ETL | ELT |
|---|---|---|
| Où se fait la transformation | Hors de la cible (Python, KNIME, SSIS…) | Dans l'entrepôt (SQL, dbt) |
| Ce qui est stocké | Uniquement les données propres | Données brutes + modèles propres |
| Langage principal | Python ou outil visuel | SQL |
| Volumes | Petits à moyens | Moyens à très gros |
| Données sensibles | Masquables avant le chargement | Les données brutes arrivent d'abord dans l'entrepôt |
| Retraitement après un changement de règle | Réextraire et relancer le pipeline | Relancer le SQL sur les tables brutes |
| Cible typique | Base sur site (MySQL, SQL Server, PostgreSQL) | Entrepôt cloud ou PostgreSQL |
Aucun des deux n'est « moderne » ou « dépassé » : beaucoup de pipelines réels mélangent les deux, avec un nettoyage léger en Python et la modélisation métier en SQL.
Comment écrire un ETL en Python ?
Voici un ETL complet qui tourne tel quel avec seulement pandas installé (pip install pandas). Il utilise SQLite, fourni avec Python : pas besoin de serveur de base de données. Les données imitent un export désordonné typique : espaces et casse incohérente dans les villes, une ligne dupliquée, une quantité manquante et des prix écrits avec une virgule décimale à la française.
Étape 1 — Extraire
import io
import sqlite3

import pandas as pd

# 1. EXTRACT: a raw export (in real life: pd.read_csv("ventes.csv") or an API)
RAW_CSV = """order_id,order_date,city,product,quantity,unit_price
1001,2026-09-01,Casablanca ,Laptop,1,"7 499,00"
1002,2026-09-01,rabat,Mouse,3,"149,00"
1003,2026-09-02,CASABLANCA,Keyboard,2,"299,00"
1003,2026-09-02,CASABLANCA,Keyboard,2,"299,00"
1004,2026-09-03,Marrakech,Mouse,,"149,00"
1005,2026-09-03,Tanger,Laptop,1,"7 499,00"
"""
raw = pd.read_csv(io.StringIO(RAW_CSV))
Étape 2 — Transformer
# 2. TRANSFORM: clean in Python before loading
df = raw.drop_duplicates().copy()
df["city"] = df["city"].str.strip().str.title()
df["order_date"] = pd.to_datetime(df["order_date"])
df["unit_price"] = (
    df["unit_price"].str.replace(" ", "", regex=False)
    .str.replace(",", ".", regex=False)
    .astype(float)
)
df = df.dropna(subset=["quantity"])
df["quantity"] = df["quantity"].astype(int)
df["amount_mad"] = df["quantity"] * df["unit_price"]
Étape 3 — Charger
# 3. LOAD: write the clean table into the target database
conn = sqlite3.connect("sales.db")
df.to_sql("sales_clean", conn, if_exists="replace", index=False)

print(pd.read_sql(
    "SELECT city, SUM(amount_mad) AS revenue_mad FROM sales_clean "
    "GROUP BY city ORDER BY revenue_mad DESC", conn))
conn.close()
Résultat attendu : Casablanca 8 097 MAD, Tanger 7 499 MAD, Rabat 447 MAD. Le doublon et la ligne sans quantité ont disparu, et « Casablanca » et « CASABLANCA » ne forment plus qu'une seule ville.
Pour charger dans PostgreSQL, installez sqlalchemy et psycopg2-binary, remplacez la connexion par create_engine("postgresql+psycopg2://user:password@localhost:5432/dwh") et passez ce moteur à to_sql (voir la documentation pandas).
Comment écrire un ELT en SQL ?
Le même pipeline en ELT : le fichier brut est chargé sans modification dans une table de staging où toutes les colonnes sont du texte, et le nettoyage se fait en SQL. Le script ci-dessous est écrit pour PostgreSQL.
-- 1. LOAD: raw data lands as-is (all text) in a staging table
DROP TABLE IF EXISTS raw_sales;
CREATE TABLE raw_sales (
  order_id   TEXT,
  order_date TEXT,
  city       TEXT,
  product    TEXT,
  quantity   TEXT,
  unit_price TEXT
);

INSERT INTO raw_sales VALUES
  ('1001', '2026-09-01', 'Casablanca ', 'Laptop',   '1', '7 499,00'),
  ('1002', '2026-09-01', 'rabat',       'Mouse',    '3', '149,00'),
  ('1003', '2026-09-02', 'CASABLANCA',  'Keyboard', '2', '299,00'),
  ('1003', '2026-09-02', 'CASABLANCA',  'Keyboard', '2', '299,00'),
  ('1004', '2026-09-03', 'Marrakech',   'Mouse',    '',  '149,00'),
  ('1005', '2026-09-03', 'Tanger',      'Laptop',   '1', '7 499,00');

-- 2. TRANSFORM: inside the warehouse, with SQL
DROP TABLE IF EXISTS sales_clean;
CREATE TABLE sales_clean AS
SELECT DISTINCT
  order_id::INT                                         AS order_id,
  order_date::DATE                                      AS order_date,
  INITCAP(TRIM(city))                                   AS city,
  product,
  quantity::INT                                         AS quantity,
  REPLACE(REPLACE(unit_price, ' ', ''), ',', '.')::NUMERIC(12, 2) AS unit_price,
  quantity::INT
    * REPLACE(REPLACE(unit_price, ' ', ''), ',', '.')::NUMERIC(12, 2) AS amount_mad
FROM raw_sales
WHERE NULLIF(TRIM(quantity), '') IS NOT NULL;

-- 3. USE: the clean model is ready for reporting
SELECT city, SUM(amount_mad) AS revenue_mad
FROM sales_clean
GROUP BY city
ORDER BY revenue_mad DESC;
Dans un vrai projet, l'INSERT est remplacé par un chargement en masse (COPY dans PostgreSQL, ou un connecteur comme Airbyte ou Fivetran), et chaque CREATE TABLE … AS SELECT devient un modèle dbt avec des tests (non nul, unique, valeurs acceptées). La table brute raw_sales reste intacte : on peut reconstruire sales_clean à tout moment. Pour aller plus loin sur la table propre, voir les requêtes SQL pour l'analyse de données.
Quand choisir l'ETL ou l'ELT ?
Choisissez l'ETL quand :
- Les volumes sont modestes et la cible est une base classique (MySQL, SQL Server, PostgreSQL sur un petit serveur).
- Les données doivent être masquées ou filtrées avant d'arriver dans l'entrepôt (données personnelles, salaires, numéros de CIN).
- Les transformations demandent des choses que le SQL fait mal : lire des PDF, appeler une API, faire de l'OCR, du rapprochement approximatif.
- L'équipe est plus à l'aise en Python ou avec un outil visuel comme KNIME.
Choisissez l'ELT quand :
- Vous utilisez un entrepôt cloud ou un PostgreSQL suffisamment dimensionné.
- Les règles métier changent souvent et vous voulez rejouer l'historique sans réextraire.
- Des analystes qui connaissent le SQL doivent pouvoir lire et modifier les transformations.
- Vous voulez des modèles SQL versionnés et testés (dbt) et une traçabilité complète du brut au propre.
Dans beaucoup d'entreprises marocaines — banques, opérateurs télécoms, distribution, organismes publics — les données partent encore d'exports d'ERP ou de fichiers Excel envoyés par e-mail. Une approche hybride est souvent la plus réaliste : une petite étape Python pour rendre les fichiers lisibles, puis de l'ELT en SQL pour la logique métier.
Quels outils pour l'ETL et l'ELT ?
| Besoin | Outils courants |
|---|---|
| ETL scripté | Python (pandas, Polars), SQLAlchemy |
| ETL visuel | KNIME, Talend, SSIS, Power Query |
| Ingestion (le E et le L de l'ELT) | Airbyte, Fivetran, COPY, connecteurs cloud |
| Transformation dans l'entrepôt | SQL, dbt |
| Orchestration et planification | Airflow, Dagster, cron, n8n pour les flux légers |
Pour une vue d'ensemble de ces architectures, le guide Microsoft Extraire, transformer et charger (ETL) est une bonne référence.
À quoi ressemble un ETL dans un vrai projet ?
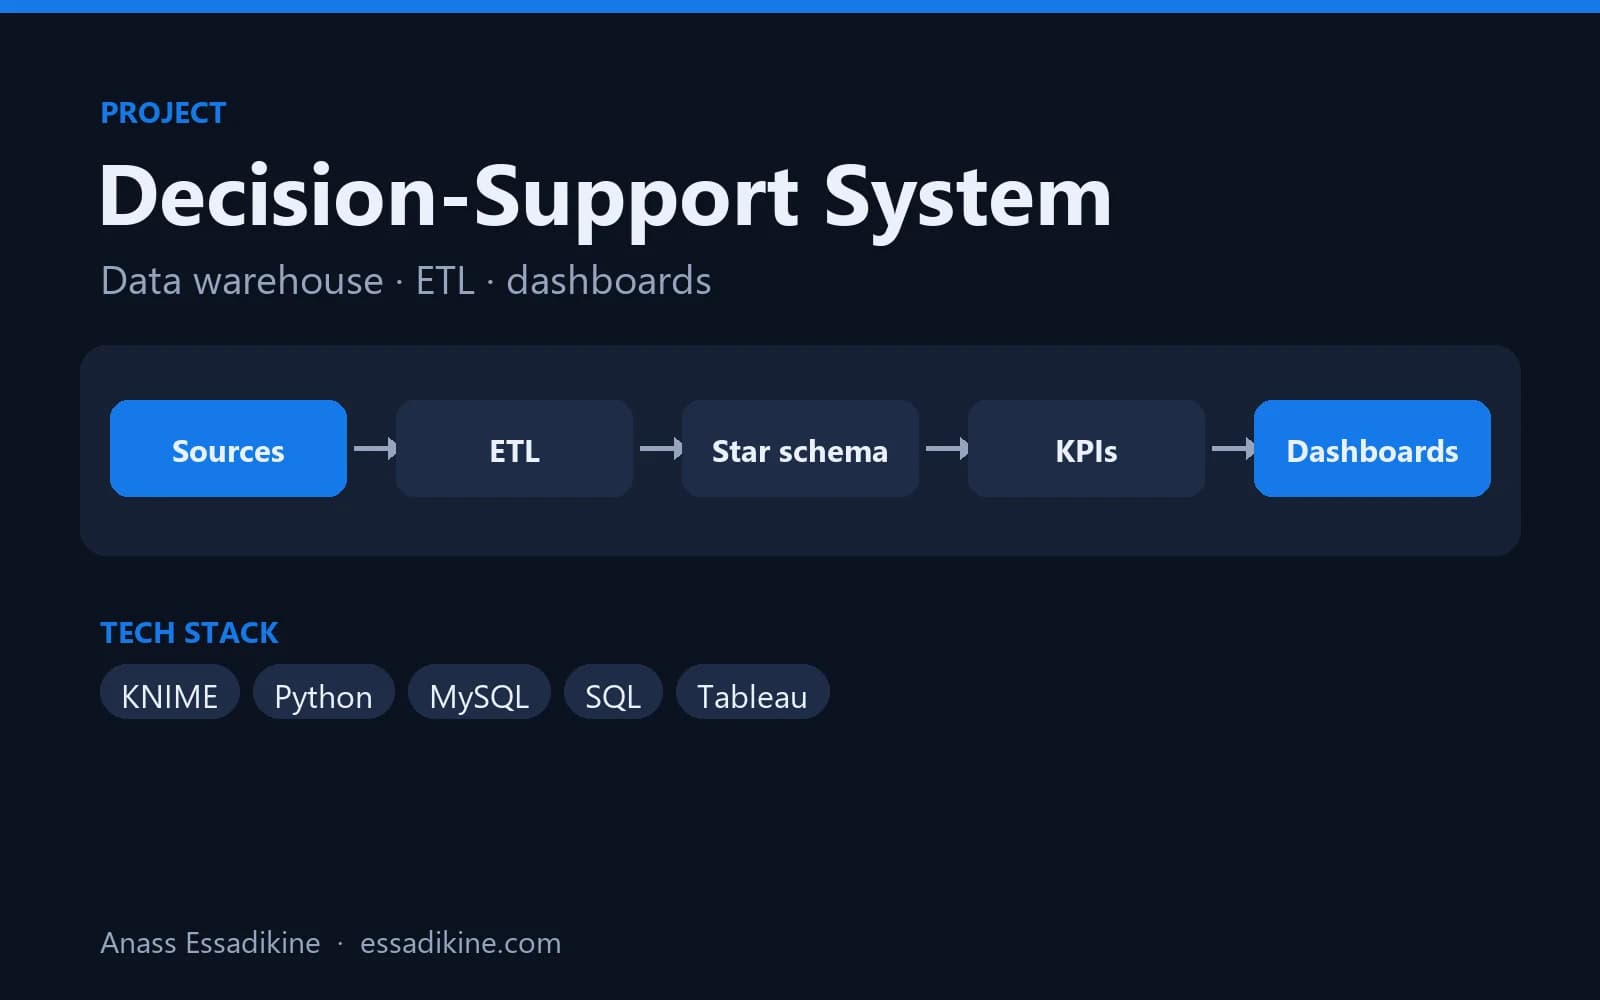
Dans le système décisionnel sur des données de type CNSS, un projet BI académique, les flux ETL ont été construits avec KNIME et Python pour nettoyer, normaliser et charger des fichiers plats dispersés dans un entrepôt MySQL modélisé en schéma en étoile, ensuite exploité par des tableaux de bord Tableau. C'est un ETL classique : les données sont nettoyées avant d'arriver dans l'entrepôt. Le modèle cible lui-même est expliqué dans data warehouse : c'est quoi ?.
Bonnes pratiques pour tout pipeline
- Conservez les données brutes, même en ETL : une copie de chaque fichier extrait permet de rejouer un chargement.
- Rendez les chargements idempotents : lancer le pipeline deux fois ne doit pas dupliquer les lignes (
if_exists="replace", upserts ou date de chargement). - Contrôlez les nombres de lignes et les totaux entre source et cible à chaque exécution.
- Journalisez les lignes rejetées au lieu de les supprimer en silence ; des contrôles comme ceux de l'article qualité des données et détection d'anomalies détectent les problèmes tôt.
- Versionnez le code (Git) et documentez chaque règle métier à côté de la transformation qui l'applique.
Conclusion
L'ETL et l'ELT ne diffèrent que sur un point — l'endroit où se fait la transformation — mais ce choix influence le coût, la traçabilité et les personnes capables de maintenir le pipeline. Partez de votre base cible et des compétences de votre équipe, gardez les données brutes quand c'est possible et n'hésitez pas à combiner Python et SQL. Pour voir comment ces pipelines s'inscrivent dans un profil data complet, consultez la page Data & AI Engineer ou le service data engineering.
Projets liés
 Analyse de données & BIProjet académique · 2025
Système décisionnel pour les données de sécurité sociale (CNSS)
Un entrepôt de données en schéma en étoile alimenté par des flux ETL, avec des tableaux de bord analytiques pour les décideurs.
Questions fréquentes
Pas complètement. L'ELT s'est généralisé avec les entrepôts cloud, capables d'exécuter les transformations à grande échelle, mais l'ETL reste pertinent pour les données sensibles, les transformations complexes hors SQL et les petites bases sur site. Beaucoup d'équipes utilisent les deux.