Machine learning pour débutant en Python : prédire des ventes avec scikit-learn
Un premier projet de machine learning exécutable en quelques minutes : générer des ventes, créer des variables, entraîner deux modèles de régression, les évaluer honnêtement et prévoir la semaine suivante.
La façon la plus simple de débuter le machine learning en Python est un petit projet concret : prévoir des ventes quotidiennes à partir d'un historique. Il faut trois bibliothèques — pandas, NumPy et scikit-learn —, quelques lignes pour transformer les dates en variables numériques, un modèle de régression et une évaluation honnête face à une référence simple. Le code complet ci-dessous tourne tel quel : il génère ses propres données, aucun fichier n'est nécessaire.
Qu'est-ce que le machine learning, simplement ?
Le machine learning (apprentissage automatique) consiste à laisser un programme apprendre une règle à partir d'exemples au lieu de l'écrire à la main. On donne au modèle des lignes de données passées — les entrées (les variables ou features) et la réponse à prédire (la cible) — et il trouve la relation entre elles. Ensuite, on lui donne de nouvelles entrées et il prédit la réponse.
On distingue trois grandes familles :
| Famille | Ce que le modèle apprend | Exemple métier |
|---|---|---|
| Supervisé – régression | Un nombre | Les ventes de demain, un délai de livraison, un prix |
| Supervisé – classification | Une catégorie | Ce client va-t-il partir ? Cette transaction est-elle suspecte ? |
| Non supervisé | Des groupes ou anomalies, sans cible | Segments de clients, points de données inhabituels |
La prévision des ventes est une régression supervisée : la cible est un nombre. C'est un bon premier projet, car les données sont faciles à comprendre et le résultat est directement utile, que ce soit pour une enseigne de distribution, une pharmacie ou un e-commerce.
De quoi a-t-on besoin pour commencer ?
- Python 3.10+ et un éditeur (VS Code) ou Jupyter.
- Les bases de Python : variables, listes, fonctions, boucles.
- Trois bibliothèques :
pip install pandas numpy scikit-learn. - De la curiosité pour les données. Pas besoin de mathématiques avancées pour débuter : on apprend d'abord l'intuition.
Comment prédire des ventes en Python, étape par étape ?
Copiez les blocs ci-dessous les uns à la suite des autres dans un seul fichier sales_forecast.py, puis lancez python sales_forecast.py. Le code et ses commentaires sont en anglais, comme dans la plupart des projets.
Étape 1 — Générer un jeu de données de ventes réaliste
Un vrai projet part de l'historique exporté d'un logiciel de caisse, d'un ERP ou d'un entrepôt de données. Ici, on construit deux ans de ventes quotidiennes pour un magasin, avec des comportements plausibles : croissance lente, week-ends plus chargés, cycle annuel, jours de promotion et bruit aléatoire.
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score

# 1. Generate two years of synthetic daily sales for one store
rng = np.random.default_rng(42)
dates = pd.date_range("2024-01-01", "2025-12-31", freq="D")
n = len(dates)

promo = rng.random(n) < 0.15                      # promotion about 15% of days
trend = np.linspace(0, 40, n)                     # slow growth
weekly = np.where(dates.dayofweek >= 5, 60, 0)    # busier weekends
yearly = 30 * np.sin(2 * np.pi * dates.dayofyear / 365.25)
noise = rng.normal(0, 15, n)

sales = 200 + trend + weekly + yearly + 80 * promo + noise
df = pd.DataFrame({"date": dates, "promo": promo.astype(int), "sales": sales.round()})
La graine (seed = 42) rend les nombres aléatoires reproductibles : vous obtenez le même jeu de données à chaque exécution.
Étape 2 — Transformer la date en variables
Un modèle ne sait pas utiliser une date telle quelle. On en extrait ce qui compte : la position dans le temps (pour la tendance), le jour de la semaine, le mois et le fait d'être un week-end.
# 2. Feature engineering: turn the date into numbers a model can use
df["day_index"] = np.arange(n)
df["day_of_week"] = df["date"].dt.dayofweek
df["month"] = df["date"].dt.month
df["is_weekend"] = (df["day_of_week"] >= 5).astype(int)
features = ["day_index", "day_of_week", "month", "is_weekend", "promo"]
Cette étape — le feature engineering — compte souvent plus que le choix de l'algorithme.
Étape 3 — Séparer les données dans le temps
Pour une prévision, il faut tester le modèle sur une période qu'il n'a jamais vue, située après la période d'entraînement. Un découpage aléatoire laisserait le modèle « regarder » le futur et donnerait des scores trop optimistes.
# 3. Time-based split: train on the past, test on the last 90 days
train, test = df.iloc[:-90], df.iloc[-90:]
X_train, y_train = train[features], train["sales"]
X_test, y_test = test[features], test["sales"]
Étape 4 — Construire une référence (baseline)
Avant tout modèle, calculez ce que donnerait une méthode naïve. Ici : toujours prédire la moyenne des quatre dernières semaines. Si votre modèle ne fait pas nettement mieux, il n'apporte rien.
# 4. Baseline: predict the average of the last 28 training days
baseline = np.full(len(test), y_train.iloc[-28:].mean())
print(f"Baseline          MAE = {mean_absolute_error(y_test, baseline):.1f}")
Étape 5 — Entraîner et comparer deux modèles
On compare une régression linéaire (simple, explicable) et une forêt aléatoire (plus flexible). La métrique est la MAE (erreur absolue moyenne) : de combien d'unités la prédiction se trompe en moyenne. Le R² indique la part de la variation expliquée (1 = parfait).
# 5. Train and compare two models
models = {
    "LinearRegression": LinearRegression(),
    "RandomForest": RandomForestRegressor(n_estimators=200, random_state=42),
}
for name, model in models.items():
    model.fit(X_train, y_train)
    pred = model.predict(X_test)
    print(f"{name:<17} MAE = {mean_absolute_error(y_test, pred):.1f}"
          f"  R2 = {r2_score(y_test, pred):.2f}")
Étape 6 — Prévoir les 7 prochains jours
# 6. Forecast the next 7 days (no promotion planned)
future_dates = pd.date_range(df["date"].max() + pd.Timedelta(days=1), periods=7)
future = pd.DataFrame({
    "date": future_dates,
    "day_index": np.arange(n, n + 7),
    "day_of_week": future_dates.dayofweek,
    "month": future_dates.month,
    "is_weekend": (future_dates.dayofweek >= 5).astype(int),
    "promo": 0,
})
future["forecast"] = models["LinearRegression"].predict(future[features]).round()
print(future[["date", "forecast"]].to_string(index=False))
Comment lire les résultats ?
Avec des versions récentes de NumPy et scikit-learn, le script affiche à peu près ceci (les valeurs exactes peuvent varier légèrement selon les versions) :
| Modèle | MAE (unités/jour) | R² |
|---|---|---|
| Référence (moyenne sur 28 jours) | environ 37 | — |
| Régression linéaire | environ 18,5 | environ 0,77 |
| Forêt aléatoire | environ 19,6 | environ 0,74 |
Trois leçons pour un débutant :
- Les deux modèles divisent par deux l'erreur de la référence. C'est la première chose à vérifier, et la raison pour laquelle la baseline passe toujours en premier.
- Le modèle le plus complexe n'est pas le meilleur ici. La forêt aléatoire ne sait pas prolonger une tendance au-delà des valeurs déjà vues, alors que la régression linéaire prolonge naturellement la croissance. Il faut toujours comparer, jamais supposer.
- La prévision est lisible. Les 7 jours prévus montrent des valeurs plus élevées le samedi et le dimanche, exactement le motif hebdomadaire des données. Si une prévision semble étrange, vérifiez les variables avant de changer d'algorithme.
Quelles erreurs éviter quand on débute ?
- Un découpage aléatoire sur des données temporelles — le futur fuit dans l'entraînement.
- Pas de référence — un score ne veut rien dire sans point de comparaison.
- Utiliser une information inconnue au moment de prédire — par exemple le nombre réel de clients du lendemain comme variable.
- Juger un modèle sur une seule métrique — regardez aussi les erreurs sur un graphique, surtout les jours fériés et de promotion.
- Négliger le nettoyage — de vraies données de ventes contiennent des jours manquants, des retours et des lignes dupliquées ; voir qualité des données et détection d'anomalies.
Comment passer de ce tutoriel à un vrai projet ?
Une vraie prévision ajoute quelques couches :
- Des données réelles extraites du système de vente et nettoyées par un pipeline (voir ETL vs ELT).
- Des variables métier : jours fériés, périodes de Ramadan et de l'Aïd pour la distribution au Maroc, calendrier scolaire, prix, ruptures de stock.
- Une validation solide sur plusieurs fenêtres temporelles successives (
TimeSeriesSplitdans scikit-learn). - La mise à disposition des prédictions : application web, API ou tableau de bord Power BI.
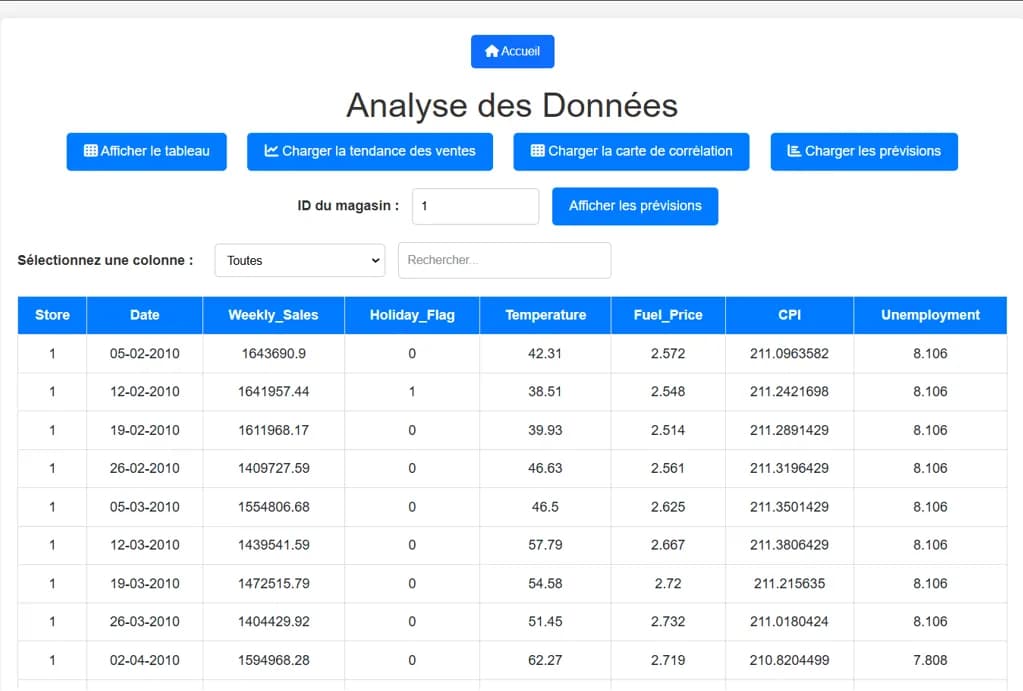
C'est le chemin suivi dans l'application Prédiction des ventes avec Django & ML, un projet académique : les données historiques ont été nettoyées et explorées avec pandas et NumPy, des modèles de régression ont été entraînés et comparés avec scikit-learn, et les prédictions et graphiques (Matplotlib, Seaborn) ont été servis dans une interface web Django au lieu de tableurs.
Pour aller plus loin, le guide officiel Getting Started de scikit-learn est court et bien écrit.
Conclusion
Un premier projet de machine learning n'exige ni big data ni mathématiques complexes : une question claire, de bonnes variables, un découpage dans le temps, une référence et deux modèles à comparer suffisent pour acquérir les bons réflexes. Lancez le script, modifiez les variables, ajoutez une colonne de jours fériés et observez l'évolution des erreurs. Pour voir comment le machine learning s'articule avec le data engineering et la BI dans un profil complet, consultez la page Data & AI Engineer.
Projets liés
 IA & AutomatisationProjet académique · 2024
Prédiction des ventes avec Django & ML
Une application web d'analyse prédictive qui prévoit les ventes et présente les résultats via des graphiques interactifs.
Questions fréquentes
Oui, pour commencer. Des bibliothèques comme scikit-learn cachent les calculs, ce qui permet d'apprendre d'abord la démarche : préparer les données, les séparer, entraîner, évaluer. Les statistiques et l'algèbre linéaire deviennent utiles ensuite, pour comprendre pourquoi un modèle se comporte ainsi.