Requêtes SQL pour l'analyse de données : 10 exemples pratiques (PostgreSQL)
Dix requêtes SQL qui répondent à de vraies questions métier, du chiffre d'affaires par ville à la croissance mensuelle et aux clients fidèles, toutes sur un même schéma de ventes.
Quelles requêtes SQL un data analyst utilise-t-il vraiment ?
Une poignée de motifs couvre l'essentiel de l'analyse au quotidien : filtrer les lignes (WHERE), les agréger (GROUP BY, HAVING), combiner des tables (JOIN), structurer la logique en étapes (WITH / CTE) et comparer les lignes entre elles (fonctions de fenêtrage). Avec les dix requêtes ci-dessous, vous pouvez répondre à la plupart des questions d'une équipe commerciale, finance ou marketing, et réussir la majorité des tests SQL en entretien.
Tous les exemples utilisent la syntaxe PostgreSQL et le même petit schéma de ventes : vous pouvez les exécuter l'un après l'autre. Les montants sont en MAD. Les noms de tables et de colonnes restent en anglais, comme dans la plupart des bases en entreprise.
Le schéma d'exemple
Quatre tables : clients (customers), produits (products), commandes (orders) et lignes de commande (order_items). Le chiffre d'affaires se calcule toujours à partir de order_items (quantité × prix unitaire au moment de la vente), et seules les commandes livrées (delivered) comptent.
CREATE TABLE customers (
    customer_id  INTEGER PRIMARY KEY,
    full_name    TEXT NOT NULL,
    city         TEXT,
    signup_date  DATE NOT NULL
);

CREATE TABLE products (
    product_id    INTEGER PRIMARY KEY,
    product_name  TEXT NOT NULL,
    category      TEXT NOT NULL,
    unit_price    NUMERIC(10, 2) NOT NULL
);

CREATE TABLE orders (
    order_id     INTEGER PRIMARY KEY,
    customer_id  INTEGER NOT NULL REFERENCES customers (customer_id),
    order_date   DATE NOT NULL,
    status       TEXT NOT NULL CHECK (status IN ('pending', 'delivered', 'cancelled'))
);

CREATE TABLE order_items (
    order_id    INTEGER NOT NULL REFERENCES orders (order_id),
    product_id  INTEGER NOT NULL REFERENCES products (product_id),
    quantity    INTEGER NOT NULL CHECK (quantity > 0),
    unit_price  NUMERIC(10, 2) NOT NULL,
    PRIMARY KEY (order_id, product_id)
);
| Table | Grain (une ligne = …) | Colonnes clés |
|---|---|---|
| customers | un client | customer_id, city, signup_date |
| products | un produit | product_id, category, unit_price |
| orders | une commande | order_id, customer_id, order_date, status |
| order_items | une ligne produit dans une commande | order_id, product_id, quantity, unit_price |
Connaître le grain de chaque table évite les doubles comptages plus tard. C'est la même idée qu'au cœur d'un modèle en étoile Power BI.
Comment filtrer et trier des données en SQL ?
1. Commandes livrées à Casablanca depuis janvier
SELECT
    o.order_id,
    o.order_date,
    c.full_name
FROM orders AS o
JOIN customers AS c ON c.customer_id = o.customer_id
WHERE c.city = 'Casablanca'
  AND o.status = 'delivered'
  AND o.order_date >= DATE '2026-01-01'
ORDER BY o.order_date DESC
LIMIT 20;
Utilisez le littéral DATE '…' pour les dates et ajoutez toujours un ORDER BY avec LIMIT, sinon les lignes renvoyées ne sont pas garanties.
Comment agréger avec GROUP BY et HAVING ?
2. Chiffre d'affaires et commandes par ville
SELECT
    c.city,
    COUNT(DISTINCT o.order_id)        AS delivered_orders,
    SUM(oi.quantity * oi.unit_price)  AS revenue_mad
FROM orders AS o
JOIN customers   AS c  ON c.customer_id = o.customer_id
JOIN order_items AS oi ON oi.order_id   = o.order_id
WHERE o.status = 'delivered'
GROUP BY c.city
HAVING COUNT(DISTINCT o.order_id) >= 10
ORDER BY revenue_mad DESC;
WHERE filtre les lignes avant le regroupement ; HAVING filtre les groupes après l'agrégation. Ici, seules les villes avec au moins 10 commandes livrées sont conservées. COUNT(DISTINCT o.order_id) est indispensable car la jointure avec order_items multiplie les lignes : une commande de trois lignes serait sinon comptée trois fois.
3. Part du chiffre d'affaires par catégorie
SELECT
    p.category,
    SUM(oi.quantity)                  AS units_sold,
    SUM(oi.quantity * oi.unit_price)  AS revenue_mad,
    ROUND(
        100.0 * SUM(oi.quantity * oi.unit_price)
        / SUM(SUM(oi.quantity * oi.unit_price)) OVER (),
        1
    )                                 AS share_of_revenue_pct
FROM order_items AS oi
JOIN orders   AS o ON o.order_id   = oi.order_id
JOIN products AS p ON p.product_id = oi.product_id
WHERE o.status = 'delivered'
GROUP BY p.category
ORDER BY revenue_mad DESC;
L'expression SUM(SUM(…)) OVER () est une fonction de fenêtrage appliquée sur l'agrégat : elle renvoie le total général sur chaque ligne, ce qui donne la part de chaque catégorie sans seconde requête.
4. Panier moyen et panier médian
WITH order_totals AS (
    SELECT
        o.order_id,
        SUM(oi.quantity * oi.unit_price) AS order_total
    FROM orders AS o
    JOIN order_items AS oi ON oi.order_id = o.order_id
    WHERE o.status = 'delivered'
    GROUP BY o.order_id
)
SELECT
    COUNT(*)                                                 AS orders,
    ROUND(AVG(order_total), 2)                               AS avg_order_value_mad,
    percentile_cont(0.5) WITHIN GROUP (ORDER BY order_total) AS median_order_value_mad,
    MAX(order_total)                                         AS max_order_value_mad
FROM order_totals;
La CTE calcule d'abord un total par commande (le bon grain), puis la requête principale agrège. Regardez toujours la médiane à côté de la moyenne : quelques très grosses commandes peuvent éloigner la moyenne d'un panier « typique ».
Comment trouver les enregistrements manquants avec un LEFT JOIN ?
5. Clients qui n'ont jamais été livrés
SELECT
    c.customer_id,
    c.full_name,
    c.city,
    c.signup_date
FROM customers AS c
LEFT JOIN orders AS o
       ON o.customer_id = c.customer_id
      AND o.status = 'delivered'
WHERE o.order_id IS NULL
ORDER BY c.signup_date;
C'est l'anti-jointure classique. Le filtre sur le statut est placé dans le ON, pas dans le WHERE : dans le WHERE, il éliminerait justement les clients sans commande. Le même résultat peut s'écrire avec NOT EXISTS, que beaucoup d'équipes trouvent plus lisible.
Comment créer des segments avec CASE WHEN ?
6. Commandes par taille de panier
WITH order_totals AS (
    SELECT
        o.order_id,
        SUM(oi.quantity * oi.unit_price) AS order_total
    FROM orders AS o
    JOIN order_items AS oi ON oi.order_id = o.order_id
    WHERE o.status = 'delivered'
    GROUP BY o.order_id
)
SELECT
    CASE
        WHEN order_total < 1000 THEN '1. < 1,000 MAD'
        WHEN order_total < 5000 THEN '2. 1,000-4,999 MAD'
        ELSE '3. >= 5,000 MAD'
    END               AS basket_size,
    COUNT(*)          AS orders,
    SUM(order_total)  AS revenue_mad
FROM order_totals
GROUP BY 1
ORDER BY 1;
Le préfixe numérique de chaque libellé garde les segments dans un ordre logique lors du tri. Adaptez les seuils à votre activité.
Comment calculer une évolution mensuelle en SQL ?
7. CA mensuel, évolution et cumul depuis le début de l'année
WITH monthly AS (
    SELECT
        date_trunc('month', o.order_date)::date AS month,
        SUM(oi.quantity * oi.unit_price)        AS revenue_mad
    FROM orders AS o
    JOIN order_items AS oi ON oi.order_id = o.order_id
    WHERE o.status = 'delivered'
    GROUP BY 1
)
SELECT
    month,
    revenue_mad,
    LAG(revenue_mad) OVER (ORDER BY month) AS previous_month_mad,
    ROUND(
        100.0 * (revenue_mad - LAG(revenue_mad) OVER (ORDER BY month))
        / NULLIF(LAG(revenue_mad) OVER (ORDER BY month), 0),
        1
    )                                      AS mom_growth_pct,
    SUM(revenue_mad) OVER (
        PARTITION BY EXTRACT(YEAR FROM month)
        ORDER BY month
    )                                      AS ytd_revenue_mad
FROM monthly
ORDER BY month;
- date_trunc('month', …) regroupe toutes les dates d'un même mois.
- LAG() lit la valeur du mois précédent sur la même ligne.
- NULLIF(…, 0) évite l'erreur de division par zéro.
- SUM() OVER (PARTITION BY année ORDER BY mois) donne un cumul annuel qui repart à zéro chaque janvier.
C'est l'équivalent SQL de la comparaison « vs mois précédent » que toute carte KPI devrait afficher (ce qui fait un bon KPI).
Comment classer et dédoublonner avec les fonctions de fenêtrage ?
8. Top 3 des produits par catégorie
WITH product_sales AS (
    SELECT
        p.category,
        p.product_name,
        SUM(oi.quantity * oi.unit_price) AS revenue_mad
    FROM order_items AS oi
    JOIN orders   AS o ON o.order_id   = oi.order_id
    JOIN products AS p ON p.product_id = oi.product_id
    WHERE o.status = 'delivered'
    GROUP BY p.category, p.product_name
),
ranked AS (
    SELECT
        category,
        product_name,
        revenue_mad,
        DENSE_RANK() OVER (PARTITION BY category ORDER BY revenue_mad DESC) AS rnk
    FROM product_sales
)
SELECT category, product_name, revenue_mad, rnk
FROM ranked
WHERE rnk <= 3
ORDER BY category, rnk;
DENSE_RANK() attribue le même rang aux ex æquo sans sauter de numéro ; RANK() en sauterait, ROW_NUMBER() départagerait arbitrairement. Choisissez en connaissance de cause.
9. Dernière commande de chaque client (et jours écoulés)
WITH ranked_orders AS (
    SELECT
        o.customer_id,
        o.order_id,
        o.order_date,
        ROW_NUMBER() OVER (
            PARTITION BY o.customer_id
            ORDER BY o.order_date DESC, o.order_id DESC
        ) AS rn
    FROM orders AS o
    WHERE o.status = 'delivered'
)
SELECT
    customer_id,
    order_id                  AS last_order_id,
    order_date                AS last_order_date,
    CURRENT_DATE - order_date AS days_since_last_order
FROM ranked_orders
WHERE rn = 1
ORDER BY days_since_last_order DESC;
ROW_NUMBER() avec PARTITION BY est la méthode standard pour garder une ligne par groupe, et c'est aussi ainsi qu'on dédoublonne des données dans un pipeline. PostgreSQL propose un raccourci équivalent :
SELECT DISTINCT ON (customer_id)
    customer_id,
    order_id,
    order_date
FROM orders
WHERE status = 'delivered'
ORDER BY customer_id, order_date DESC, order_id DESC;
En PostgreSQL, soustraire deux DATE renvoie un nombre de jours, ce qui simplifie les calculs de récence.
Comment mesurer la fidélisation client en SQL ?
10. Taux de réachat à 90 jours par cohorte de première commande
WITH first_orders AS (
    SELECT
        customer_id,
        MIN(order_date) AS first_order_date
    FROM orders
    WHERE status = 'delivered'
    GROUP BY customer_id
),
repeaters AS (
    SELECT DISTINCT f.customer_id
    FROM first_orders AS f
    JOIN orders AS o
      ON o.customer_id = f.customer_id
     AND o.status = 'delivered'
     AND o.order_date >  f.first_order_date
     AND o.order_date <= f.first_order_date + 90
)
SELECT
    date_trunc('month', f.first_order_date)::date      AS cohort_month,
    COUNT(*)                                           AS new_customers,
    COUNT(r.customer_id)                               AS repeat_within_90_days,
    ROUND(100.0 * COUNT(r.customer_id) / COUNT(*), 1)  AS repeat_rate_pct
FROM first_orders AS f
LEFT JOIN repeaters AS r ON r.customer_id = f.customer_id
GROUP BY 1
ORDER BY 1;
Chaque client est rattaché au mois de sa première commande livrée (sa cohorte), puis la requête vérifie s'il a recommandé dans les 90 jours. En PostgreSQL, ajouter un entier à une DATE ajoute des jours. C'est un KPI de fidélisation simple et facile à expliquer.
Comment vérifier la qualité des données avant d'analyser ?
Avant de faire confiance aux chiffres ci-dessus, lancez quelques contrôles sur chaque table :
SELECT
    COUNT(*)                               AS total_rows,
    COUNT(*) - COUNT(city)                 AS missing_city,
    COUNT(*) - COUNT(DISTINCT customer_id) AS duplicate_ids,
    MIN(signup_date)                       AS first_signup,
    MAX(signup_date)                       AS last_signup
FROM customers;

SELECT
    lower(trim(full_name)) AS normalised_name,
    city,
    COUNT(*)               AS occurrences
FROM customers
GROUP BY lower(trim(full_name)), city
HAVING COUNT(*) > 1;
COUNT(colonne) ignore les NULL, donc COUNT(*) − COUNT(city) donne le nombre de villes manquantes. La seconde requête repère les quasi-doublons de clients dont le nom ne diffère que par la casse ou des espaces. Ce type de contrôle systématique est approfondi dans qualité des données et détection d'anomalies.
Aide-mémoire SQL : question → technique
| Question métier | Technique SQL |
|---|---|
| Quelles lignes respectent une condition ? | WHERE, ORDER BY, LIMIT |
| Total ou moyenne par groupe ? | GROUP BY + SUM / AVG / COUNT |
| Garder seulement les groupes significatifs ? | HAVING |
| Combiner clients, commandes, produits ? | INNER JOIN |
| Qui n'a jamais fait X ? | LEFT JOIN … IS NULL ou NOT EXISTS |
| Logique en plusieurs étapes ? | WITH (CTE) |
| Comparer avec la période précédente ? | LAG() OVER (ORDER BY …) |
| Cumul ou cumul annuel ? | SUM() OVER (PARTITION BY … ORDER BY …) |
| Top N par groupe, dédoublonnage ? | ROW_NUMBER / DENSE_RANK |
| Valeur typique robuste aux extrêmes ? | percentile_cont(0.5) WITHIN GROUP |
Quelles erreurs éviter ?
- Le double comptage après jointure : agrégez d'abord au bon grain (CTE), puis joignez.
- Filtrer un LEFT JOIN dans le WHERE : il se transforme silencieusement en jointure interne.
- La division entière : en PostgreSQL, 1 / 3 renvoie 0 ; multipliez par 100.0 pour forcer les décimales.
- Oublier les NULL : NULL = NULL n'est pas vrai ; utilisez IS NULL et COALESCE.
- Des bornes de dates floues : soyez explicite (>= début, < début suivant).
La documentation officielle de PostgreSQL sur les fonctions de fenêtrage est une excellente lecture complémentaire.
Conclusion
Dix motifs, un seul schéma : filtrage, regroupement, jointures, CTE, segments CASE, comparaisons de périodes, classements, dédoublonnage, cohortes et contrôles qualité. Ensemble, ils couvrent l'essentiel de ce qu'un data analyst écrit chaque semaine et de ce qu'un data engineer utilise dans ses pipelines. Les mêmes fondations SQL ont servi à préparer et interroger l'entrepôt du projet décisionnel CNSS.
Si vous développez vos compétences, consultez la feuille de route data analyst au Maroc. Si vous avez besoin de pipelines SQL fiables pour vos propres données, voyez le service data engineering.
Projets liés
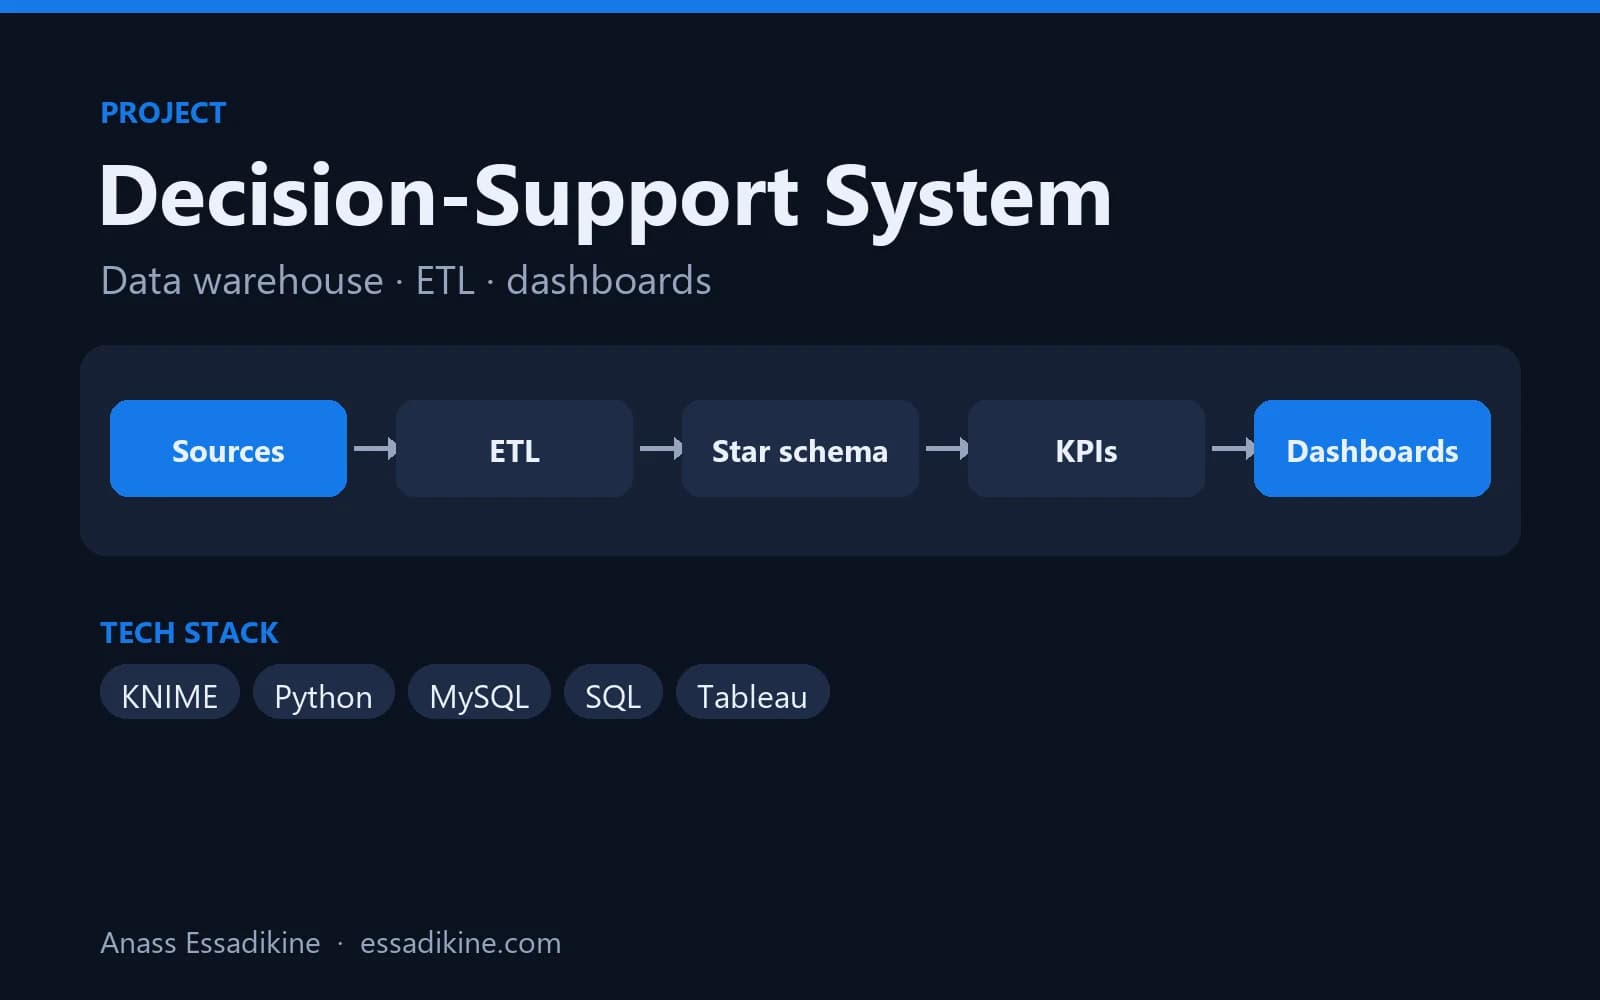 Analyse de données & BIProjet académique · 2025
Système décisionnel pour les données de sécurité sociale (CNSS)
Un entrepôt de données en schéma en étoile alimenté par des flux ETL, avec des tableaux de bord analytiques pour les décideurs.
Questions fréquentes
Le cœur du langage est le même sous PostgreSQL, MySQL, SQL Server, BigQuery ou Snowflake. PostgreSQL est un bon choix pour apprendre : gratuit, proche du standard, il gère les fonctions de fenêtrage, les CTE et les agrégats avancés.