Data warehouse : c'est quoi ? Définition, schéma en étoile et exemple SQL
Un data warehouse est une base de données conçue pour l'analyse, pas pour les opérations quotidiennes. Voici ce que cela signifie, comment un schéma en étoile l'organise, et un exemple retail complet en SQL.
Un data warehouse (ou entrepôt de données) est une base de données conçue pour l'analyse plutôt que pour les opérations quotidiennes. Il rassemble les données de plusieurs sources (ERP, CRM, caisses, fichiers Excel), les nettoie, conserve leur historique et les organise pour répondre vite et de façon cohérente à des questions comme « combien avons-nous vendu par région et par mois ? ». La plupart des entrepôts sont modélisés en schéma en étoile : une table de faits centrale entourée de tables de dimensions.
Qu'est-ce qu'un data warehouse ?
La définition classique, due à Bill Inmon, décrit l'entrepôt de données comme orienté sujet, intégré, historisé et non volatil. Concrètement :
- Orienté sujet — organisé autour des thèmes métier (ventes, clients, stocks), pas autour des applications.
- Intégré — un même client ou produit a un seul code et un seul libellé, même si chaque source le nomme différemment.
- Historisé — les données sont conservées dans le temps, pour comparer cette année à l'année dernière.
- Non volatil — les données sont chargées puis lues ; elles ne sont pas modifiées par les transactions du quotidien.
L'entrepôt se place entre les systèmes opérationnels et les outils de reporting (Power BI, Tableau, Looker Studio). Il est alimenté par des pipelines ETL ou ELT (voir ETL vs ELT).
Quelle différence entre une base de données et un data warehouse ?
Une base applicative et un entrepôt peuvent tourner tous les deux sur PostgreSQL ou SQL Server. La différence tient à leur rôle et à leur modélisation.
| Critère | Base opérationnelle (OLTP) | Data warehouse (OLAP) |
|---|---|---|
| Rôle | Faire tourner l'activité : enregistrer ventes, commandes, paiements | Analyser l'activité : tendances, KPI, comparaisons |
| Requête typique | Lire ou modifier une ligne | Agréger des millions de lignes |
| Modèle | Normalisé (beaucoup de petites tables) | Schéma en étoile dénormalisé |
| Historique | État actuel, souvent écrasé | Conservé sur plusieurs années |
| Utilisateurs | Applications, opérateurs | Analystes, managers, outils BI |
| Mises à jour | Continues, ligne par ligne | Chargements par lots (quotidiens, horaires) |
Lancer des rapports lourds directement sur la base de production ralentit l'application et donne des chiffres qui changent entre deux actualisations. C'est souvent le moment où une entreprise a besoin d'un entrepôt.
Data warehouse, data lake, datamart : quelle différence ?
| Terme | Ce qu'il stocke | Usage typique |
|---|---|---|
| Data warehouse | Données structurées, nettoyées, modélisées | Reporting, KPI, tableaux de bord |
| Datamart | Un sous-ensemble de l'entrepôt pour un service | Reporting finance, commercial ou RH |
| Data lake | Fichiers bruts de tout format (CSV, JSON, logs, images) | Data science, archivage, ingestion |
| Lakehouse | Un data lake avec des fonctions d'entrepôt (tables, SQL, transactions) | Analytique et data science |
Pour une entreprise qui a surtout besoin d'un reporting fiable, un entrepôt bien modélisé sur PostgreSQL ou SQL Server suffit souvent. Le data lake devient utile avec de gros volumes de données non structurées.
Qu'est-ce qu'un schéma en étoile ?
Un schéma en étoile contient deux types de tables :
- Table de faits — une ligne par événement mesuré, à un grain précis (par exemple une ligne de ticket de caisse). Elle contient les mesures numériques (quantité, montant) et les clés étrangères vers les dimensions.
- Tables de dimensions — le contexte descriptif pour filtrer et regrouper : date, produit, magasin, client.
Voici le schéma en étoile d'une enseigne de distribution avec plusieurs magasins :
                    ┌──────────────┐
                    │   dim_date   │
                    │  date_key PK │
                    └──────┬───────┘
                           │
┌──────────────┐   ┌───────┴────────┐   ┌───────────────┐
│  dim_store   │   │   fact_sales   │   │  dim_product  │
│ store_key PK ├───┤ date_key FK    ├───┤ product_key PK│
└──────────────┘   │ store_key FK   │   └───────────────┘
                   │ product_key FK │
                   │ customer_key FK│
                   │ quantity       │
                   │ sales_amount   │
                   └───────┬────────┘
                           │
                   ┌───────┴────────┐
                   │  dim_customer  │
                   │customer_key PK │
                   └────────────────┘
Le grain de cet exemple : une ligne de fact_sales = une ligne produit sur un ticket de caisse. Définir le grain en premier est la décision de modélisation la plus importante.
Comment créer un schéma en étoile en SQL ?
Les instructions ci-dessous sont écrites pour PostgreSQL et s'exécutent telles quelles dans une base vide. Les noms de tables et de colonnes restent en anglais, comme c'est l'usage dans la plupart des équipes data.
Étape 1 — Créer les dimensions
CREATE TABLE dim_date (
  date_key      INT PRIMARY KEY,          -- e.g. 20261012
  full_date     DATE NOT NULL UNIQUE,
  day_of_month  SMALLINT NOT NULL,
  month_number  SMALLINT NOT NULL,
  month_name    VARCHAR(20) NOT NULL,
  quarter       SMALLINT NOT NULL,
  year_number   SMALLINT NOT NULL,
  is_weekend    BOOLEAN NOT NULL
);

CREATE TABLE dim_store (
  store_key     INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  store_code    VARCHAR(20) NOT NULL UNIQUE,  -- code in the source system
  store_name    VARCHAR(100) NOT NULL,
  city          VARCHAR(60) NOT NULL,
  region        VARCHAR(60) NOT NULL,
  store_type    VARCHAR(30)                   -- hypermarket, proximity...
);

CREATE TABLE dim_product (
  product_key   INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  product_code  VARCHAR(30) NOT NULL UNIQUE,
  product_name  VARCHAR(150) NOT NULL,
  category      VARCHAR(60) NOT NULL,
  subcategory   VARCHAR(60),
  brand         VARCHAR(60)
);

CREATE TABLE dim_customer (
  customer_key  INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  customer_code VARCHAR(30) NOT NULL,
  segment       VARCHAR(30),                  -- loyalty, occasional...
  city          VARCHAR(60),
  valid_from    DATE NOT NULL DEFAULT CURRENT_DATE,
  valid_to      DATE,                          -- NULL = current version
  is_current    BOOLEAN NOT NULL DEFAULT TRUE
);
dim_customer contient valid_from, valid_to et is_current : c'est une dimension à évolution lente de type 2 (SCD 2). Quand un client déménage de Rabat à Casablanca, une nouvelle version de la ligne est créée, et les ventes passées restent rattachées à l'ancienne ville.
Étape 2 — Créer la table de faits
CREATE TABLE fact_sales (
  sale_line_id      BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  date_key          INT NOT NULL REFERENCES dim_date (date_key),
  store_key         INT NOT NULL REFERENCES dim_store (store_key),
  product_key       INT NOT NULL REFERENCES dim_product (product_key),
  customer_key      INT REFERENCES dim_customer (customer_key), -- NULL if anonymous
  receipt_number    VARCHAR(30) NOT NULL,
  quantity          INT NOT NULL,
  unit_price_mad    NUMERIC(12, 2) NOT NULL,
  discount_mad      NUMERIC(12, 2) NOT NULL DEFAULT 0,
  sales_amount_mad  NUMERIC(12, 2) NOT NULL
);

CREATE INDEX idx_fact_sales_date     ON fact_sales (date_key);
CREATE INDEX idx_fact_sales_store    ON fact_sales (store_key);
CREATE INDEX idx_fact_sales_product  ON fact_sales (product_key);
CREATE INDEX idx_fact_sales_customer ON fact_sales (customer_key);
Étape 3 — Remplir la dimension date
INSERT INTO dim_date
SELECT
  TO_CHAR(d, 'YYYYMMDD')::INT,
  d::DATE,
  EXTRACT(DAY FROM d),
  EXTRACT(MONTH FROM d),
  TO_CHAR(d, 'FMMonth'),
  EXTRACT(QUARTER FROM d),
  EXTRACT(YEAR FROM d),
  EXTRACT(ISODOW FROM d) IN (6, 7)
FROM generate_series('2024-01-01'::DATE, '2027-12-31'::DATE, INTERVAL '1 day') AS d;
Les autres dimensions et la table de faits sont remplies par le pipeline ETL/ELT à partir des systèmes sources, qui traduit les codes sources en clés de substitution (store_key, product_key…).
Étape 4 — Interroger l'entrepôt
Une fois chargé, une question métier typique devient une requête simple :
-- Revenue by region and product category in 2026
SELECT
  s.region,
  p.category,
  SUM(f.sales_amount_mad) AS revenue_mad,
  SUM(f.quantity)         AS units_sold
FROM fact_sales f
JOIN dim_date    d ON d.date_key    = f.date_key
JOIN dim_store   s ON s.store_key   = f.store_key
JOIN dim_product p ON p.product_key = f.product_key
WHERE d.year_number = 2026
GROUP BY s.region, p.category
ORDER BY revenue_mad DESC;
Toutes les requêtes suivent le même schéma : la table de faits au centre, des jointures vers les dimensions utiles, des filtres et regroupements sur les colonnes des dimensions. C'est exactement ce que fait Power BI en coulisses, d'où l'efficacité du modèle en étoile dans Power BI branché sur un entrepôt.
Quels outils pour construire un data warehouse ?
| Couche | Options courantes |
|---|---|
| Stockage | PostgreSQL, SQL Server, Oracle, MySQL ; dans le cloud BigQuery, Snowflake, Azure Synapse / Microsoft Fabric, Redshift |
| Chargement et transformation | Python, SQL, dbt, KNIME, SSIS, Talend |
| Orchestration | Airflow, Dagster, cron, SQL Server Agent |
| Restitution | Power BI, Tableau, Looker Studio |
Au Maroc, les organisations qui ont beaucoup de transactions et plusieurs systèmes à réconcilier — banques, assurances, opérateurs télécoms, enseignes de distribution, grands organismes publics — sont les utilisateurs typiques d'entrepôts de données. Une PME peut commencer avec une seule base PostgreSQL et quelques tables de faits bien définies. Le guide Microsoft sur la conception d'un schéma en étoile est une bonne référence pour les règles de modélisation.
Un exemple réel d'entrepôt en étoile
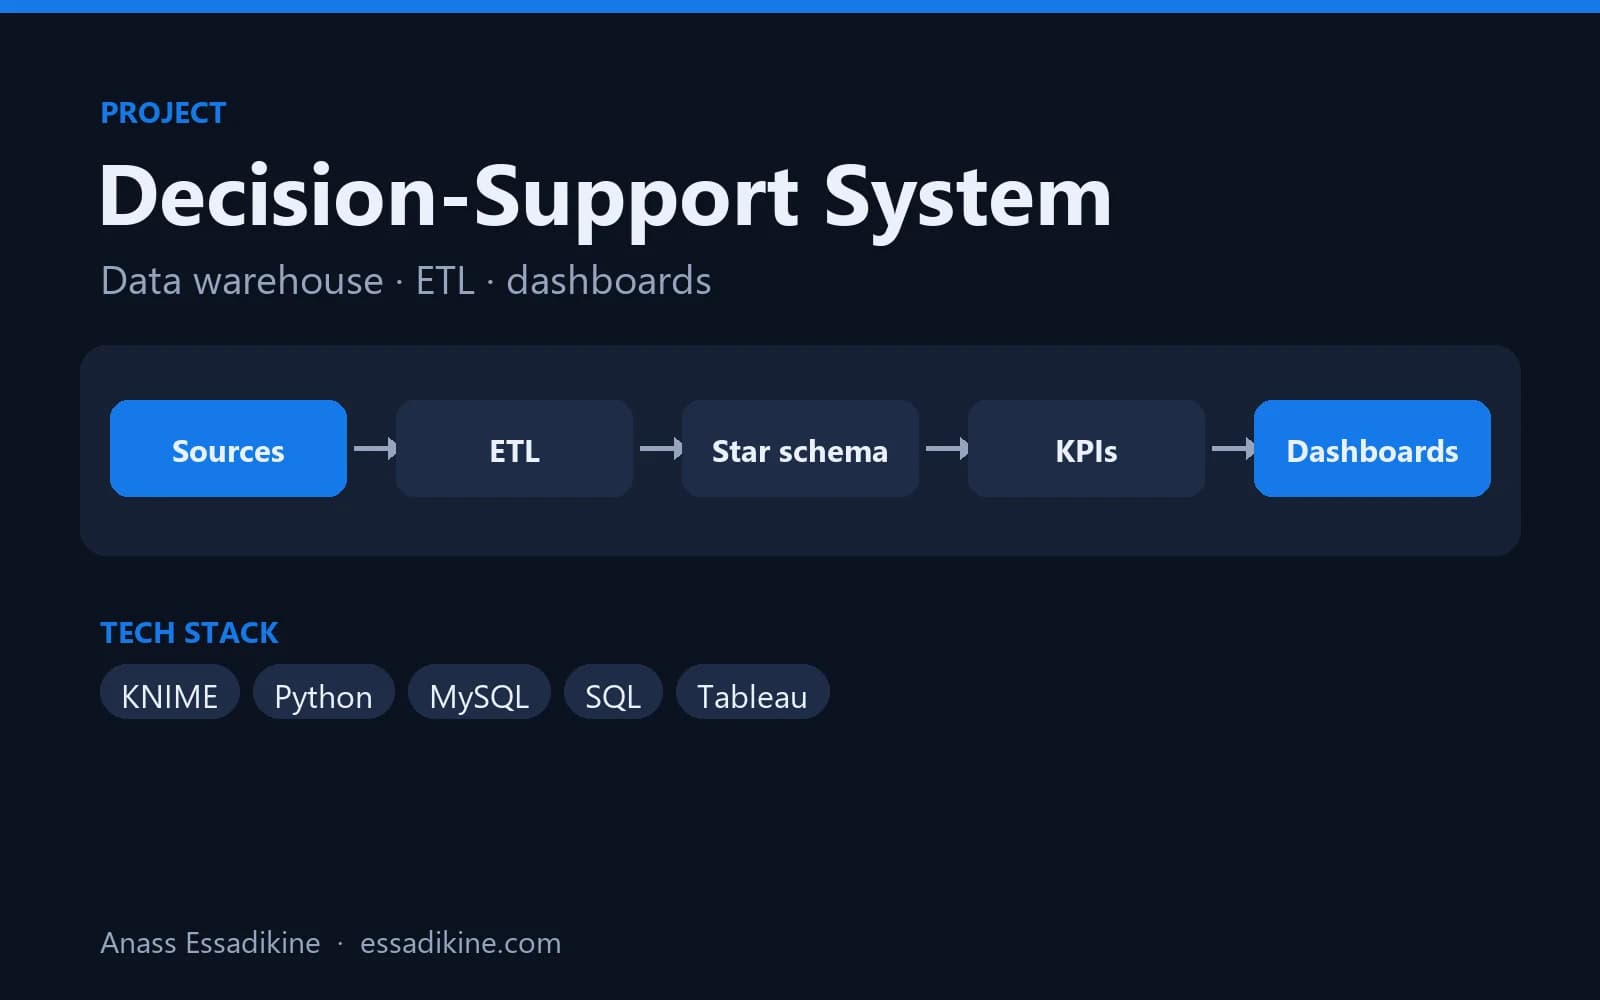
Le système décisionnel sur des données de type CNSS est un projet BI académique construit selon cette approche : un schéma en étoile (table de faits et dimensions) pour des données de type sécurité sociale, des flux ETL avec KNIME et Python pour nettoyer et normaliser des fichiers plats dispersés, un entrepôt MySQL et des tableaux de bord Tableau filtrables par période, région et catégorie.
Erreurs de modélisation fréquentes
- Pas de grain défini — mélanger lignes de ticket et totaux journaliers dans la même table de faits provoque des doubles comptages.
- Utiliser les codes sources comme clés — les clés de substitution protègent l'entrepôt quand un système source change ses codes.
- Des mesures stockées en texte — un montant en texte ne s'additionne pas de façon fiable.
- Pas de dimension date — chaque analyse temporelle demande alors des fonctions de date bricolées.
- Tout passer en flocon — découper les dimensions en nombreuses sous-tables complique les requêtes et les modèles BI ; gardez des dimensions plates quand c'est possible.
Conclusion
Un data warehouse n'est pas « une base plus grosse » : c'est un modèle conçu pour répondre aux questions métier avec des chiffres cohérents et historisés. Commencez par un seul processus métier, définissez le grain, construisez une table de faits et quelques dimensions, puis élargissez. Pour aller plus loin, le service data engineering et la page Data & AI Engineer décrivent comment ces entrepôts sont conçus et alimentés.
Projets liés
 Analyse de données & BIProjet académique · 2025
Système décisionnel pour les données de sécurité sociale (CNSS)
Un entrepôt de données en schéma en étoile alimenté par des flux ETL, avec des tableaux de bord analytiques pour les décideurs.
Questions fréquentes
Oui, c'est un type de base de données, mais conçu pour l'analyse et non pour les opérations. Il rassemble les données de plusieurs sources, conserve l'historique et utilise un modèle, en général en étoile, optimisé pour les agrégations.